长 PDF 同时包含正文、表格和图片。直接切片会损失结构语义;跨文档问答还需要解决主体歧义、版本串扰与检索结果不稳定。
RAG · MULTIMODAL DOCUMENTS
多模态 RAG 知识库问答系统
面向产品手册、财报与招股书等复杂长文档,搭建从结构化导入、多模态解析到可追溯问答的完整链路。
01 / CONTEXT
问题与目标
让系统先确认用户所指的文档主体,再检索具体内容;回答过程既能利用图文信息,也能保持不同文档和版本之间的隔离。
02 / SYSTEM
系统如何运转
01 · INGEST文档上传与领域识别→
02 · PARSEMinerU + 视觉模型解析图文→
03 · RETRIEVEBGE-M3 混合向量召回→
04 · RERANKWeightedRanker + RRF + Reranker→
05 · ANSWERLangGraph 编排与流式问答
03 / PRODUCT
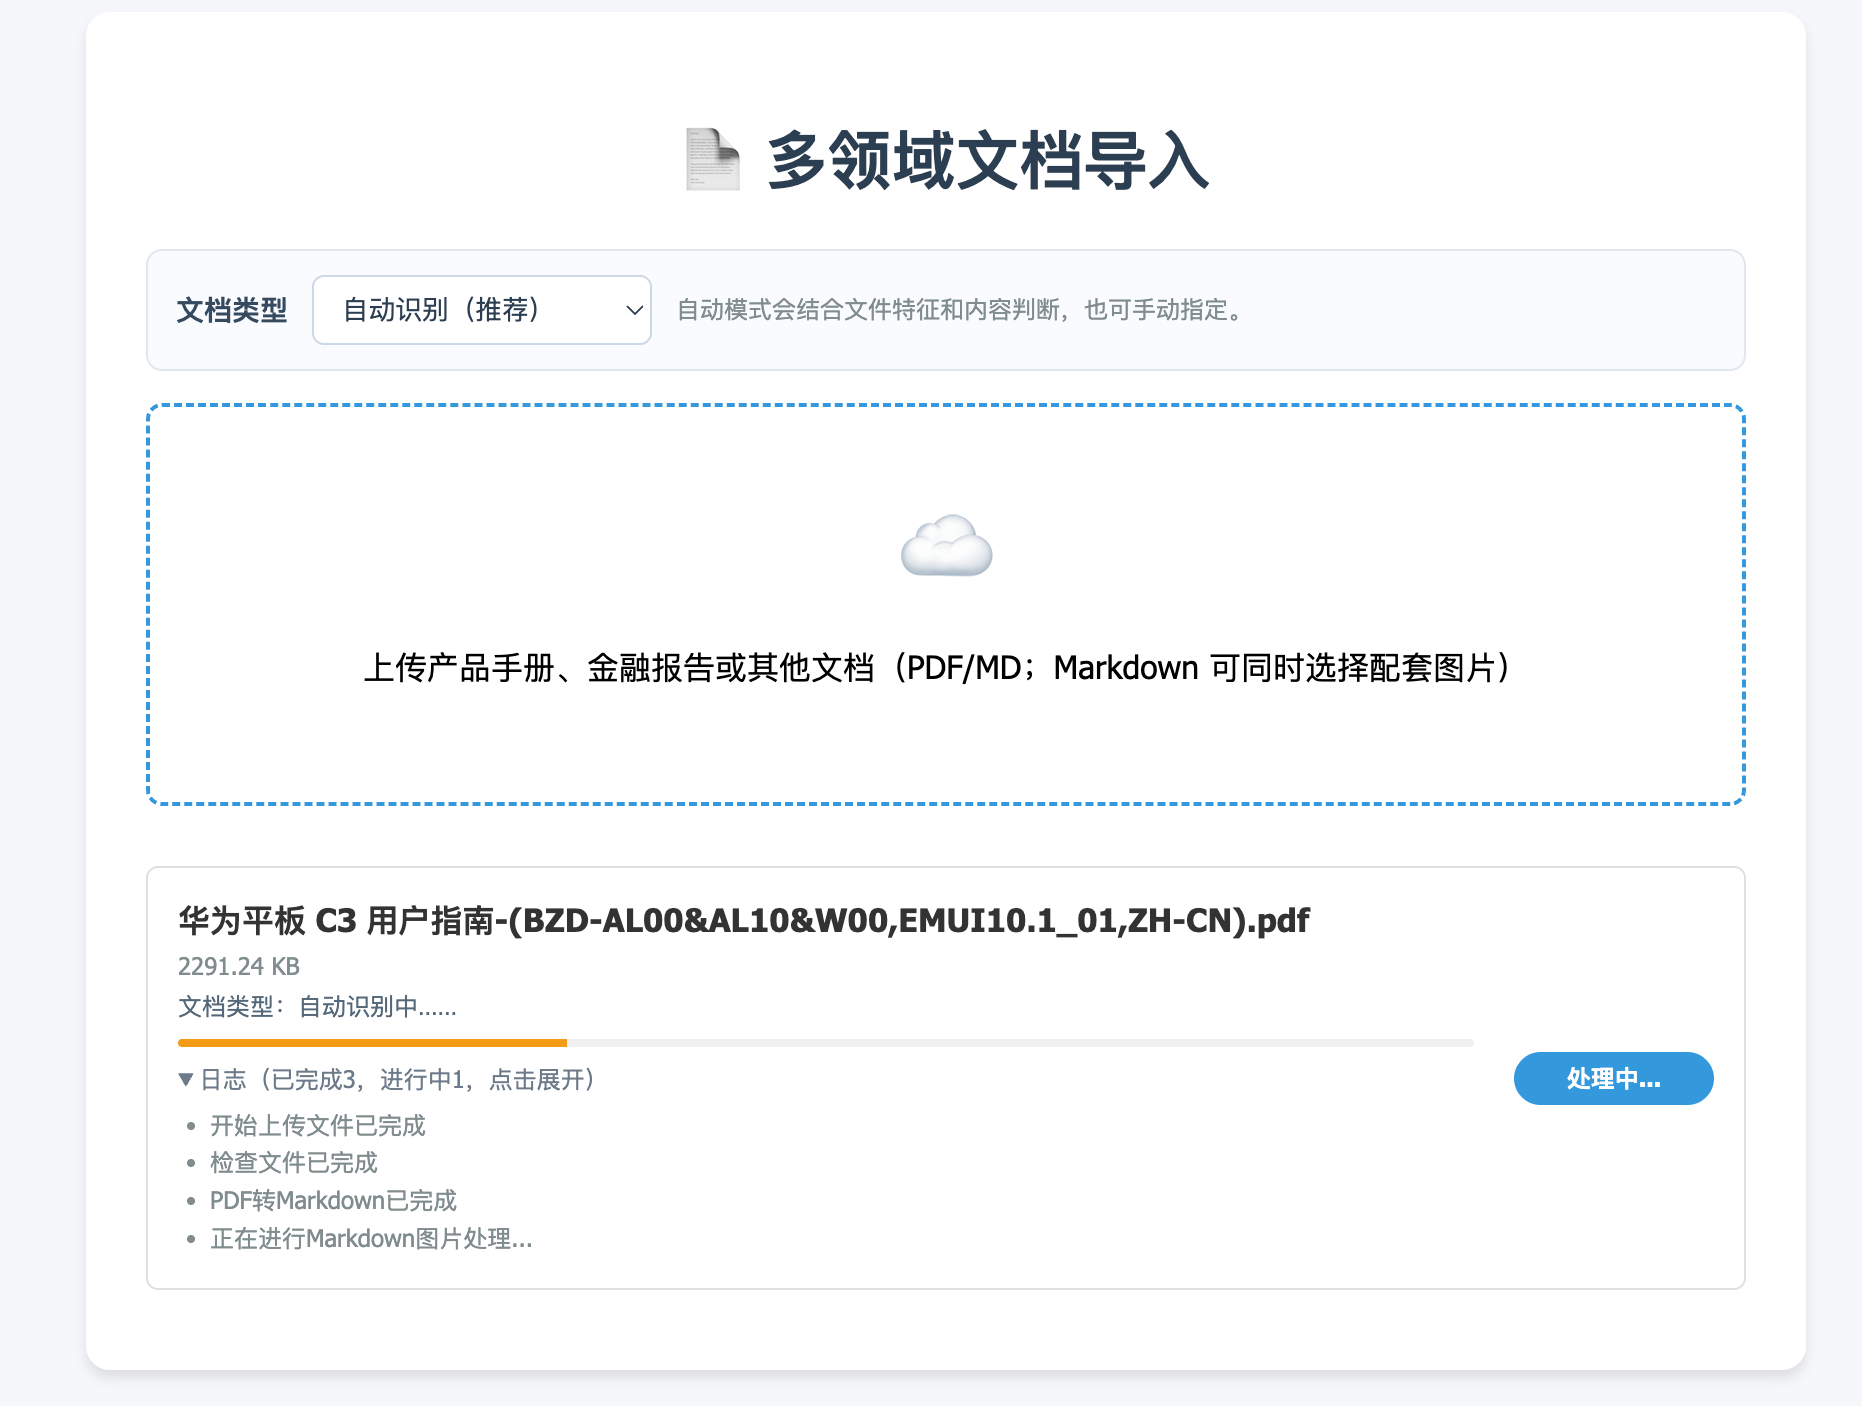
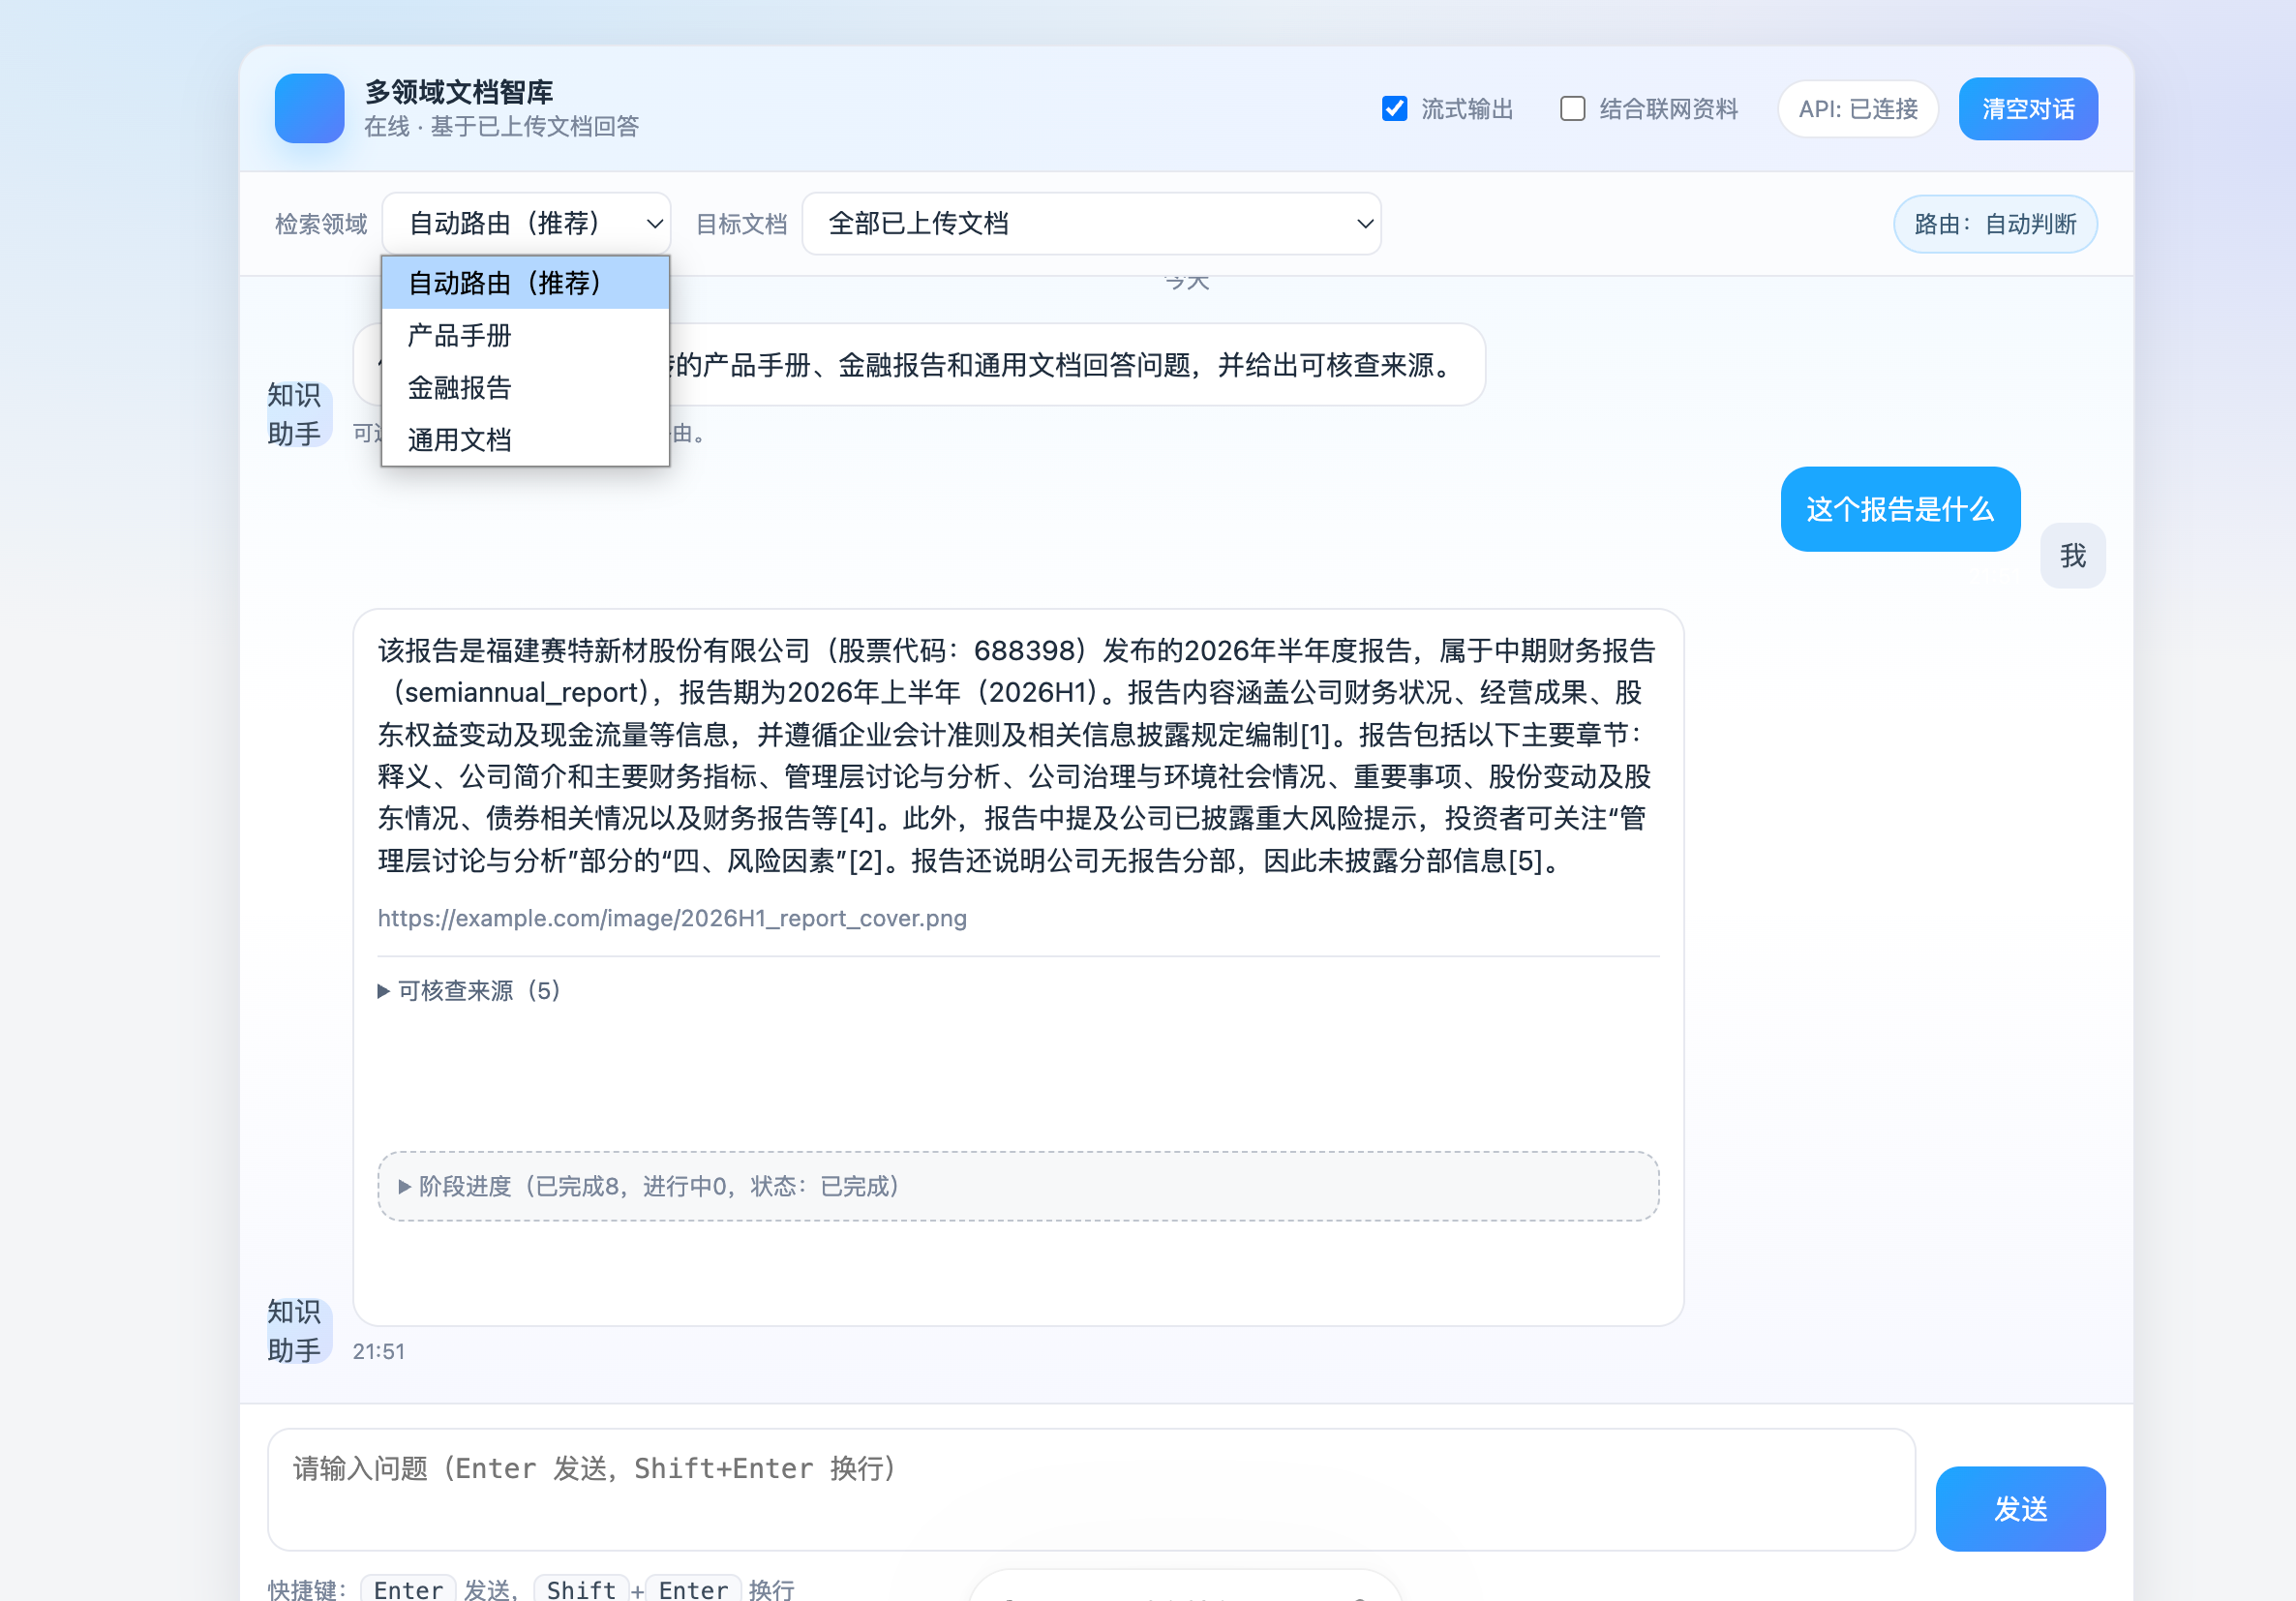
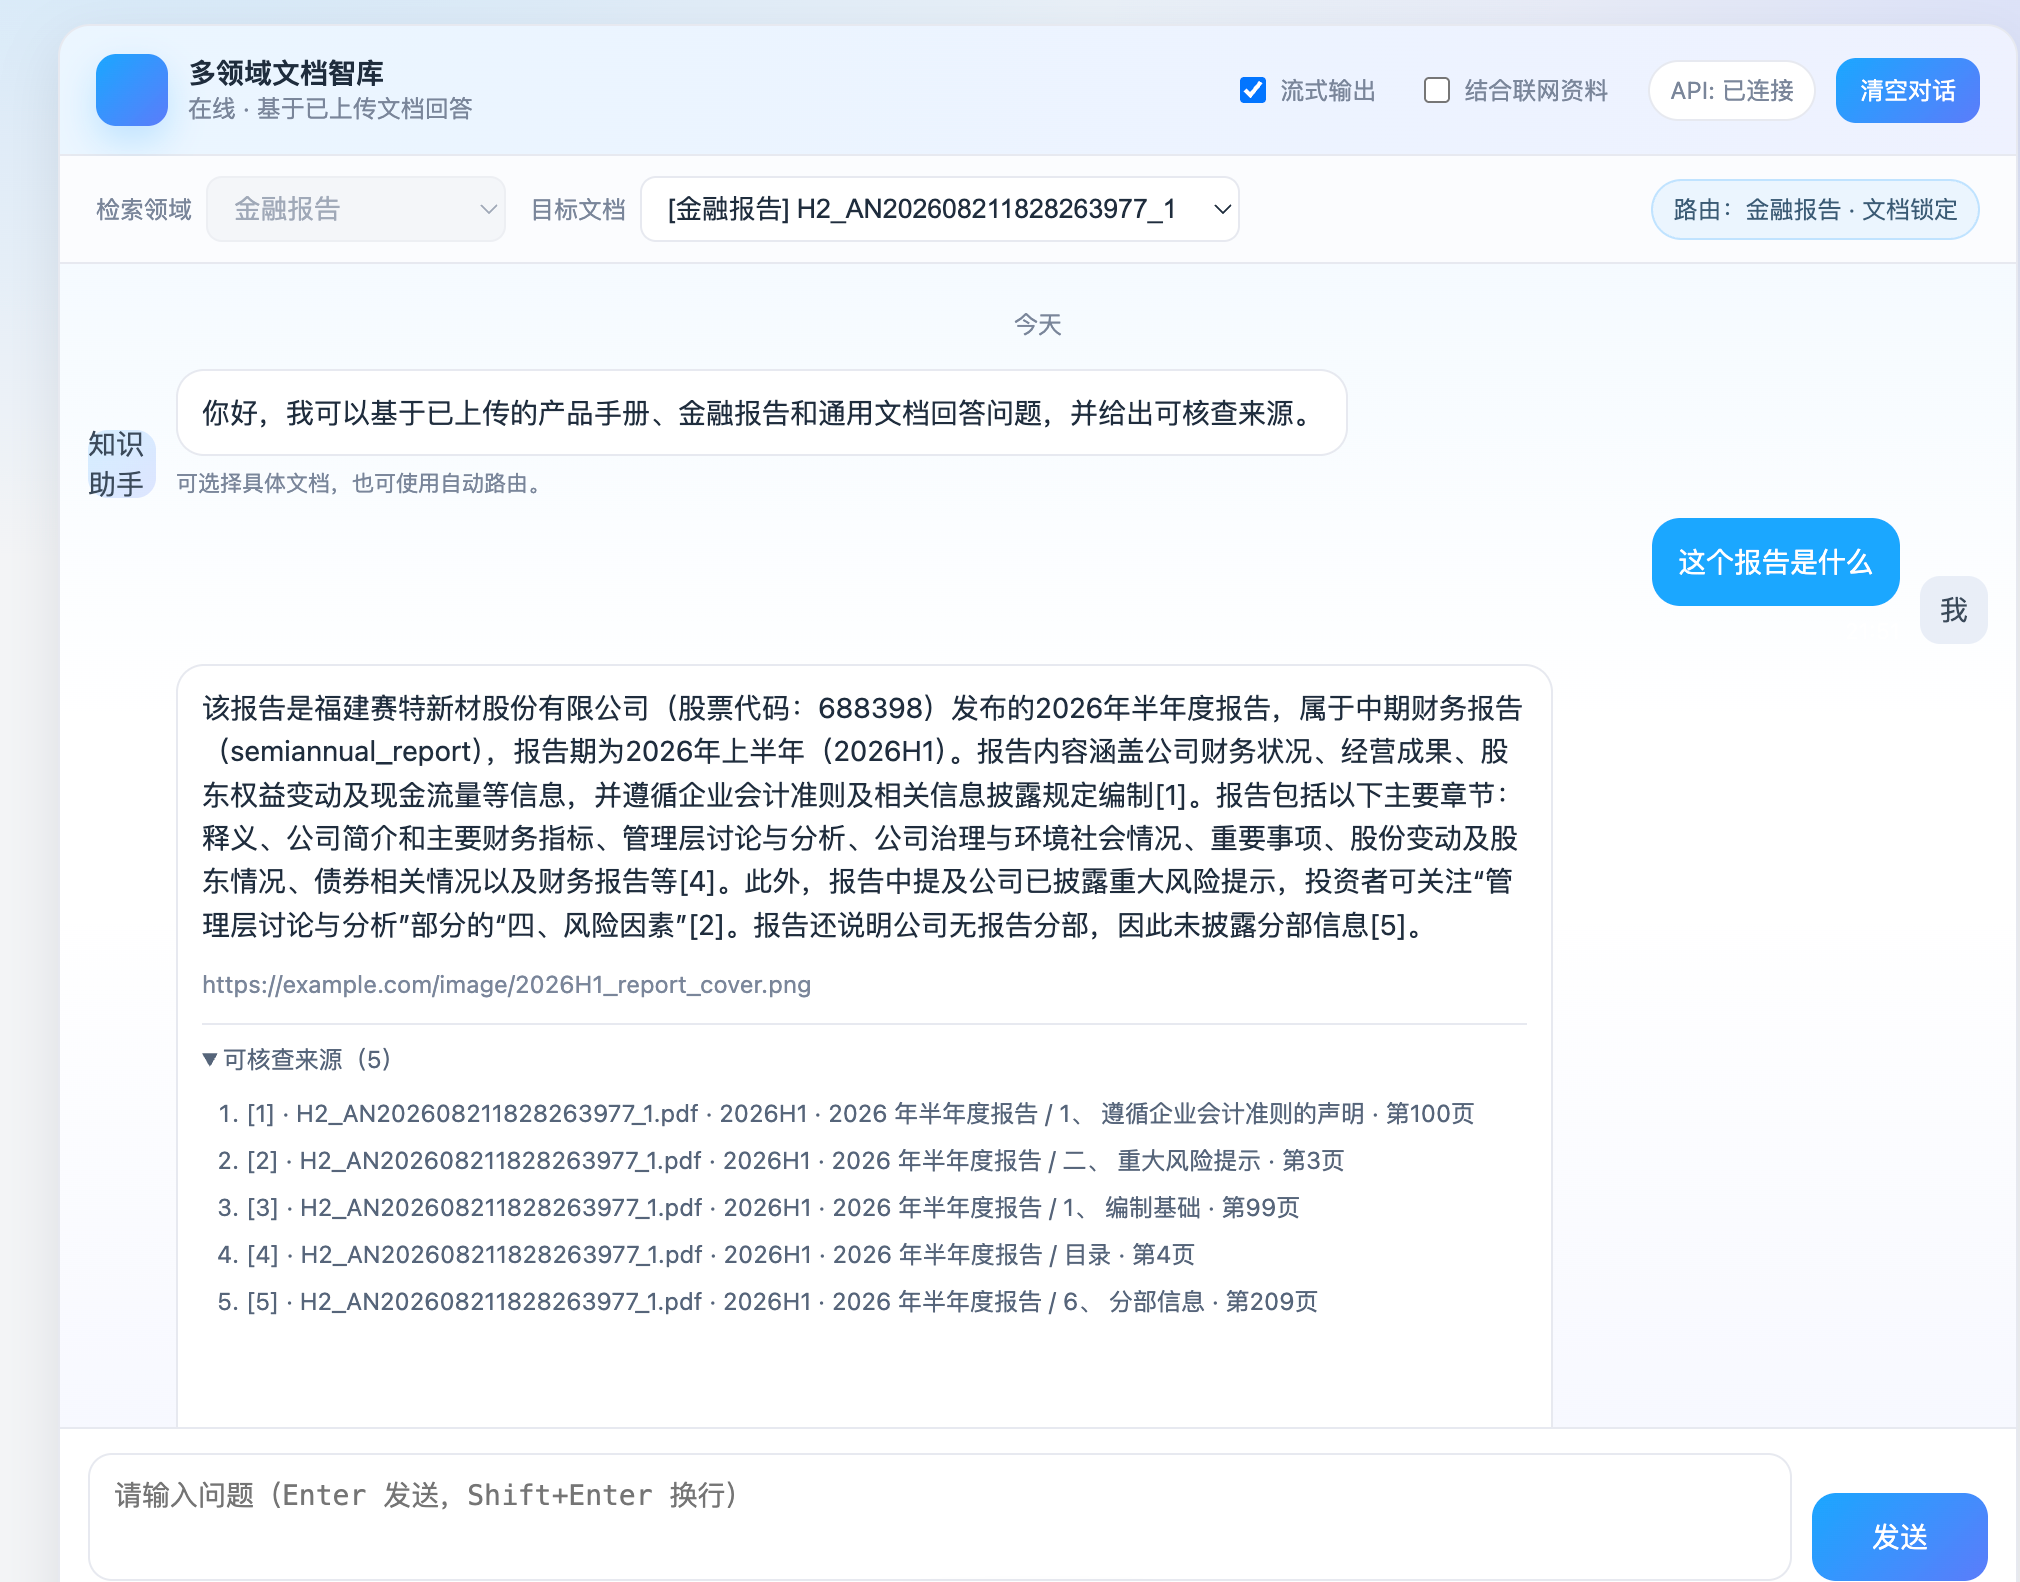
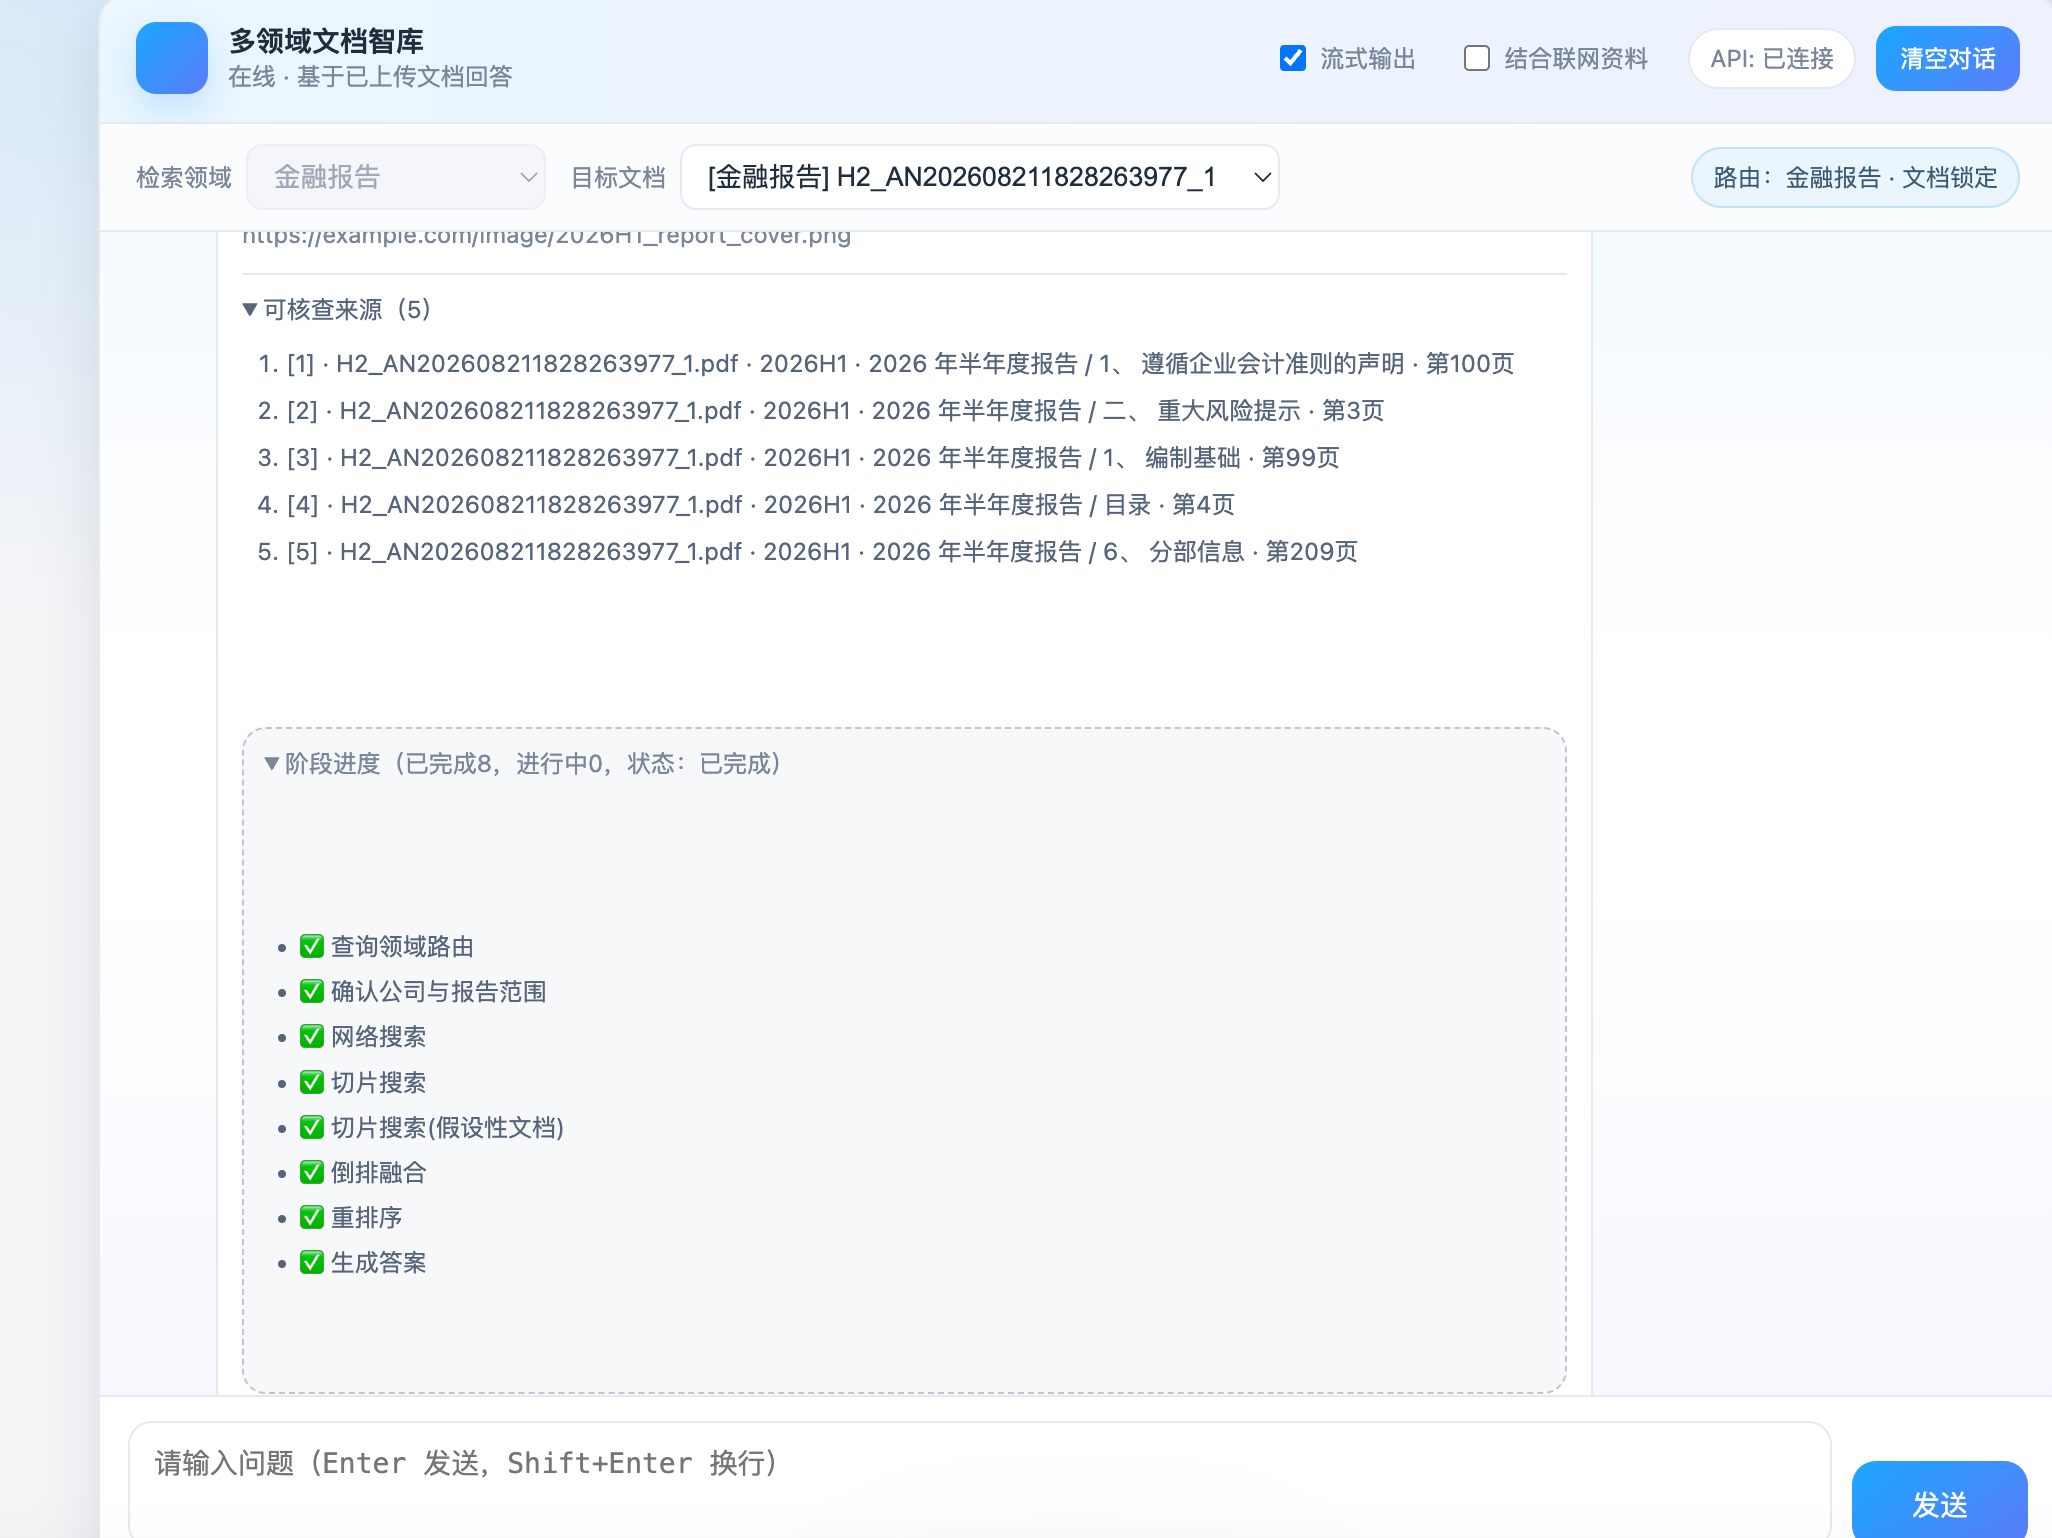
从文档导入到可追溯回答
真实产品界面覆盖文档处理、检索路由、来源引用和 Agent 执行过程,让系统能力不仅停留在架构描述,也能被直接体验和验证。
04 / DECISIONS
三个关键设计决策
先确认主体,再检索内容
将问答拆成“主体确认—内容检索”两个阶段。面对同名产品、多个财报期或指代不清的问题,先完成实体对齐和歧义澄清,再进入内容召回。
保留图文关系与版本信息
用 MinerU 和视觉大模型拆分解析长 PDF,抽取 OCR、表格、图片与摘要;原图版本化存储到 MinIO,元数据和多轮历史由 MongoDB 管理。
混合召回后再做精排
结合 BGE-M3、Milvus WeightedRanker、RRF 与 Qwen3-Reranker,在语义召回之外加入融合与重排,支持多条件精确过滤。
05 / VALIDATION
如何验证结果
- 检索隔离:检查不同文档主体之间不会发生内容串扰。
- 版本一致性:更新文档后,问答使用正确版本的文本与原图。
- 异常回滚:导入失败时,不留下不完整文档状态。
- 接口体验:FastAPI/SSE 持续返回异步导入与流式回答状态。
STACK
PythonFastAPILangGraphBGE-M3MilvusMongoDBMinIODocker
KEEP EXPLORING
下一项目 · Data Agent →